Wie zuverlässig ist KI-Extraktion? Halluzinationen erkennen, Ergebnisse prüfen
Gültiges JSON heißt nicht, dass die Werte stimmen. Fehlertypen mit Beispiel, Prüfungen ohne KI, Belege im Original und Freigabe durch Menschen.
· Plurali
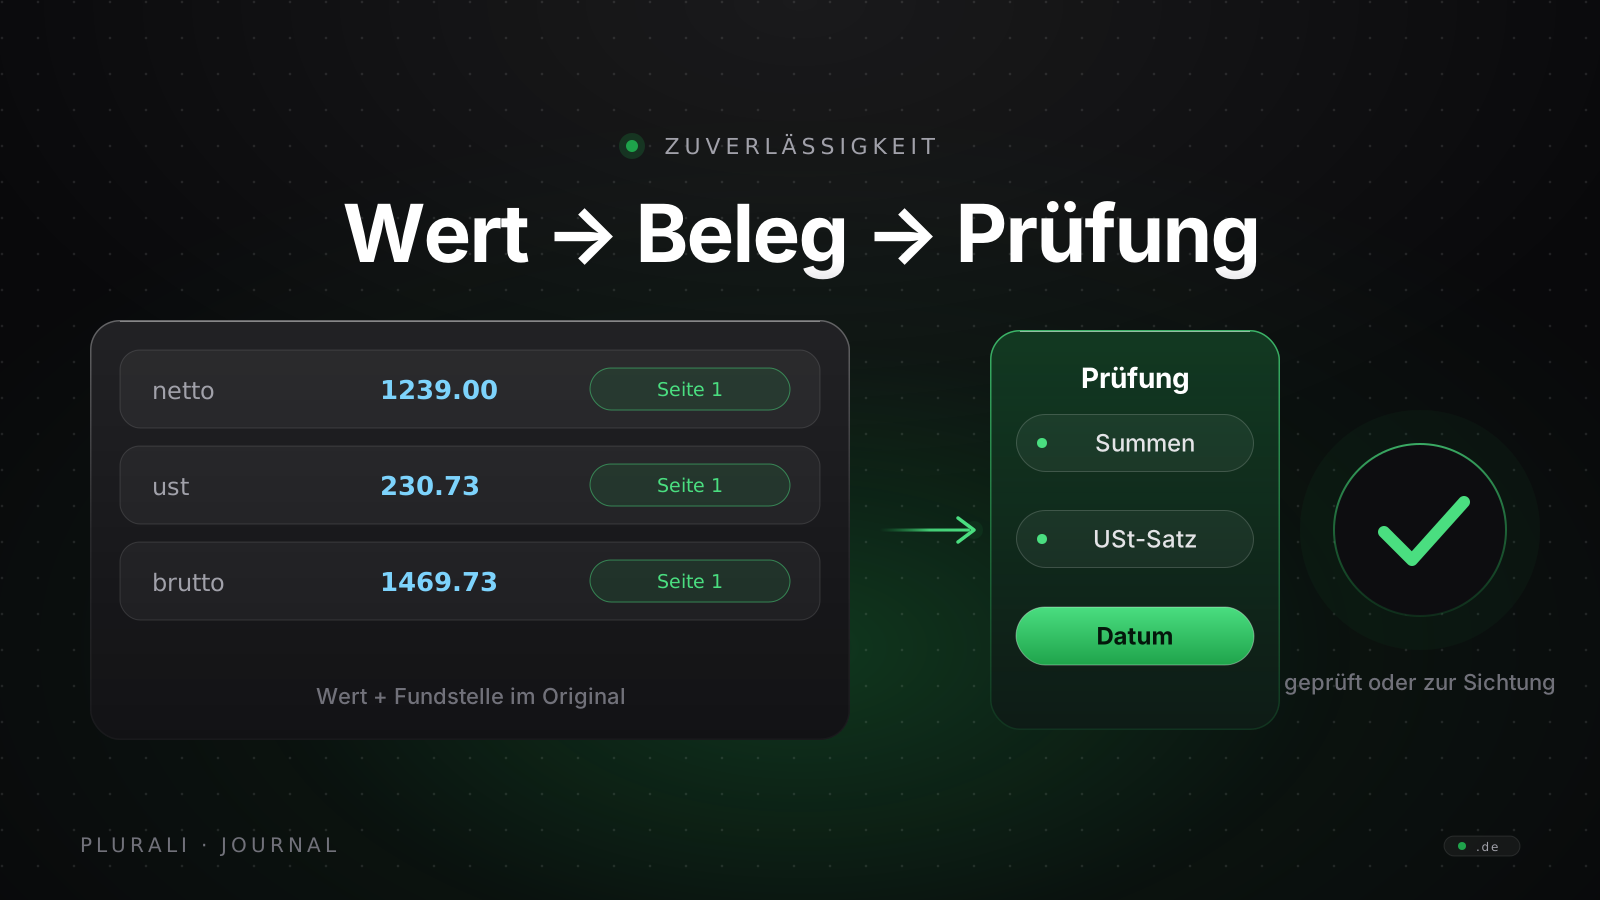
KI-Extraktion liest Dokumente nicht immer richtig, und ein gültiges JSON beweist nichts. Das Schema garantiert, dass ein Feld brutto eine Zahl enthält. Es garantiert nicht, dass es die Zahl ist, die auf dem Beleg steht. Wer Werte ungeprüft in Buchhaltung oder ERP übernimmt, übernimmt auch die Fehler.
Dieser Artikel zeigt, welche Fehler auftreten, wie Sie die meisten davon ohne weitere KI erkennen, was ein Beleg im Original leistet und ab wann sich die Prüfung durch Menschen rechnet. Als durchgehendes Beispiel dient die Rechnung RE-2026-0412 der Muster GmbH: 8 Stunden Beratung zu 150,00 EUR (19 % USt.) und ein Fachbuch zu 39,00 EUR (7 % USt.), netto 1.239,00 EUR, USt. 230,73 EUR, brutto 1.469,73 EUR, Rechnungsdatum 1. September 2026, fällig am 30. September 2026.
Stand: 29. September 2026
Gültig ist nicht richtig
Ein Modell, das Ihr Schema befolgt, liefert Werte vom richtigen Typ in der richtigen Struktur. Ob der Wert stimmt, prüft das Schema nicht. Dazu kommt: Sprachmodelle raten, wenn sie etwas nicht finden oder nicht lesen können. Das ist der Kern dessen, was man Halluzination nennt: eine plausibel aussehende Angabe, die im Dokument nicht steht.
Bei Dokumenten kommen drei Ursachen zusammen. Die Vorlage ist schlecht lesbar (Scan, Foto, Stempel über der Zahl). Das Feld ist mehrdeutig definiert (welches Datum ist "das" Datum?). Oder das Dokument enthält den Wert schlicht nicht, das Schema verlangt ihn aber. Wie Vision-Modelle Dokumente lesen und wo ihre Grenzen liegen, beschreibt der Artikel zu GenAI-OCR. Hier geht es um das, was danach kommt: erkennen und absichern.
Vier Fehlertypen mit Beispiel
Alle Beispiele beziehen sich auf die Rechnung RE-2026-0412. Es sind konstruierte Fehler, die zeigen, wie sie aussehen. Es sind keine Messwerte.
| Fehlertyp | Beispiel auf der Rechnung | Was das Schema sagt | Was ihn verrät |
|---|---|---|---|
| Falscher Wert | Brutto 1.469,73 wird als 1.469 gelesen (Punkt und Komma vertauscht) oder als 1.489,73 (Ziffer verwechselt) | gültig, ist eine Zahl | Summenprobe: Netto plus USt. ergibt nicht Brutto |
| Erfundener Wert | Auf der Rechnung steht keine Bestellnummer, das Modell liefert 4500012345 | gültig, ist ein String | Beleg im Original: Der Wert steht nirgends im Dokument |
| Falsches Feld | rechnungsdatum und faellig_am sind vertauscht: 2026-09-30 und 2026-09-01 | gültig, beides Daten | Datumsreihenfolge: Fälligkeit vor Rechnungsdatum |
| Fehlend, als Null gelesen | Es gibt kein Skonto, das Modell liefert skonto_prozent: 0 statt null | gültig, ist eine Zahl | nur die Feld-Definition und der Beleg; die Summen stimmen weiterhin |
Der vierte Typ ist der tückischste. Zwischen "nicht vorhanden" (null) und "vorhanden und null" (0) besteht ein fachlicher Unterschied: Eine Rechnung ohne Skonto-Angabe ist etwas anderes als eine, die ausdrücklich 0 % Skonto nennt. Definieren Sie deshalb optionale Felder als nullbar und schreiben Sie in die Beschreibung, dass null gilt, wenn das Dokument nichts dazu sagt. Das beugt dem Fehler vor, ersetzt aber nicht die Kontrolle.
Bei der Datumsvertauschung lohnt ein zweiter Blick auf das Format. Auf deutschen Belegen steht 01.09.2026. Ein Modell, das 09.01.2026 daraus macht, liefert ein gültiges Datum, das vier Monate zu früh liegt. Die Reihenfolge-Prüfung fängt das nicht immer ab. Ein Zahlungsziel von 264 Tagen dagegen fällt bei einer Plausibilitätsgrenze auf.
Prüfungen ohne KI
Die billigste und schnellste Absicherung sind deterministische Regeln. Sie sind reproduzierbar, kosten nichts pro Aufruf und behaupten nicht, etwas zu verstehen. Für Rechnungen genügen wenige:
| Prüfung | Regel | Beispiel RE-2026-0412 |
|---|---|---|
| Positionssumme | Menge mal Einzelpreis, summiert, gleich Netto | 8 × 150,00 + 1 × 39,00 = 1.239,00 |
| Umsatzsteuer je Satz | Nettobetrag je Satz mal Satz, gleich USt. | 1.200,00 × 19 % = 228,00; 39,00 × 7 % = 2,73; Summe 230,73 |
| Brutto | Netto plus USt. gleich Brutto | 1.239,00 + 230,73 = 1.469,73 |
| Steuersatz | nur bekannte Sätze (in Deutschland 0, 7, 19 %) | 19 und 7: in Ordnung |
| Datumsreihenfolge | Fälligkeit nicht vor Rechnungsdatum; Zahlungsziel unter einer Obergrenze | 1. September vor 30. September, 29 Tage |
| IBAN | Prüfsumme nach Modulo 97 | siehe Code unten |
| Pflichtangaben | Felder, die auf einer Rechnung stehen müssen, sind nicht null | Nummer, Datum, Betrag, Lieferant |
Eine Toleranz von einem Cent ist sinnvoll, wenn der Lieferant je Position rundet und nicht je Steuersatz. Alles darüber ist ein Prüfhinweis, kein Rundungseffekt.
So sieht das als kleines, lauffähiges Python aus. Es rechnet mit Decimal, damit keine Gleitkommafehler entstehen:
from datetime import date
from decimal import Decimal as D

def iban_ok(iban: str) -> bool:
    s = iban.replace(" ", "").upper()
    if not (15 <= len(s) <= 34) or not s.isalnum():
        return False
    moved = s[4:] + s[:4]  # die ersten vier Zeichen ans Ende
    return int("".join(str(int(c, 36)) for c in moved)) % 97 == 1

def pruefe(r: dict) -> list[str]:
    fehler = []
    netto = sum(D(str(p["menge"])) * D(str(p["einzelpreis"])) for p in r["positionen"])
    ust = sum(D(str(p["menge"])) * D(str(p["einzelpreis"])) * D(p["ust_satz"]) / 100
              for p in r["positionen"]).quantize(D("0.01"))
    if netto != D(str(r["netto"])):
        fehler.append(f"Netto: berechnet {netto}, gelesen {r['netto']}")
    if ust != D(str(r["ust"])):
        fehler.append(f"USt.: berechnet {ust}, gelesen {r['ust']}")
    if netto + ust != D(str(r["brutto"])):
        fehler.append(f"Brutto: berechnet {netto + ust}, gelesen {r['brutto']}")
    if any(p["ust_satz"] not in (0, 7, 19) for p in r["positionen"]):
        fehler.append("USt.-Satz ist kein deutscher Satz (0, 7, 19)")
    rd, fd = date.fromisoformat(r["rechnungsdatum"]), date.fromisoformat(r["faellig_am"])
    if fd < rd:
        fehler.append("Fälligkeit liegt vor dem Rechnungsdatum")
    elif (fd - rd).days > 90:
        fehler.append("Zahlungsziel über 90 Tage: bitte ansehen")
    if r.get("iban") and not iban_ok(r["iban"]):
        fehler.append("IBAN-Prüfsumme falsch")
    return fehler
Wir haben die Funktionen gegen die Beispielrechnung laufen lassen. Mit den richtigen Werten liefert pruefe eine leere Liste. Mit Brutto 1489.73 meldet sie "Brutto: berechnet 1469.73, gelesen 1489.73". Mit dem Satz 19 statt 7 beim Fachbuch schlagen USt. und Brutto an. Die Beispiel-IBAN DE89 3704 0044 0532 0130 00 besteht die Prüfung, mit geänderter letzter Ziffer nicht. Das Wort "IBAN-Prüfsumme" ist wörtlich zu nehmen: Sie zeigt, dass die Nummer in sich stimmig ist, nicht dass das Konto existiert oder dem Lieferanten gehört.
Diese Regeln erkennen Fehler, die Zahlen untereinander widersprüchlich machen. Sie erkennen nicht, wenn das Modell konsistent falsch liegt. Liest es Menge 8 als 6 und rechnet die Summen passend mit, stimmt alles bis auf den Beleg. Und sie erkennen nicht den vierten Fehlertyp. Dafür brauchen Sie den Blick ins Dokument.
Der Beleg: Wert und Fundstelle im Original
Ein Wert ohne Fundstelle zwingt den Prüfer, das Dokument selbst zu durchsuchen. Ein Wert mit Fundstelle lässt sich in Sekunden bestätigen. Deshalb lohnt es sich, im Schema neben dem Wert ein Feld für den Beleg zu verlangen: Seite und den wörtlichen Ausschnitt, aus dem der Wert stammt.
{
  "rechnungsnummer": "RE-2026-0412",
  "brutto": 1469.73,
  "quelle": {
    "brutto": { "seite": 1, "text": "Gesamtbetrag brutto 1.469,73 EUR" }
  },
  "skonto_prozent": null,
  "quelle_skonto": null
}
Das Beispiel zeigt zwei Dinge. Erstens: Der Ausschnitt lässt sich maschinell prüfen. Enthält das Dokument (bei Scans: der erkannte Text) den Satz 1.469,73 auf Seite 1, ist der Wert belegt. Steht er nirgends, ist es ein Verdachtsfall. Damit lassen sich erfundene Werte fangen. Zweitens: null samt fehlender Quelle ist eine ehrliche Antwort. Ein Feld skonto_prozent: 0 mit der Quelle "Skonto: 0 %" wäre nur richtig, wenn diese Zeile existiert.
Ein Vorbehalt gehört dazu. Auch die Fundstelle stammt vom Modell und kann falsch sein. Sie ersetzt die Prüfung nicht, sie macht sie schneller und maschinell kontrollierbar. Die Feldnamen quelle und text im Beispiel sind unsere Wahl im Schema. Plurali liefert genau die Felder, die Sie im Schema verlangen, und liefert nichts aus, was nicht zum Schema passt. Was ein Feld bedeutet, entscheiden Sie mit der Beschreibung.
Prüfung durch Menschen (Human in the Loop)
Human in the Loop heißt: Eine Person sieht sich Ergebnisse an, bevor sie weiterverarbeitet werden. Das muss nicht für jedes Dokument gelten. Bewährt hat sich ein gestufter Ablauf:
Dokument
   |
   v
Extraktion (Schema)
   |
   v
Prüfungen ohne KI: Summen, Sätze, Daten, IBAN, Beleg im Text
   |
   +-- alle bestanden ---> Stichprobe (z. B. jedes 10.) ---> Übernahme
   |
   +-- mindestens eine fehlgeschlagen ---> Prüfung durch Mensch
                                              (Wert neben Ausschnitt im Original)
                                                     |
                                                     v
                                                  Übernahme
Die Zeichnung zeigt: Regeln entscheiden, welche Dokumente ein Mensch sieht. Bestandene Dokumente laufen weiter, ein kleiner Teil geht als Stichprobe trotzdem zur Kontrolle. So bleibt der Aufwand klein, und die Stichprobe zeigt, ob die Regeln etwas übersehen.
Wann sich die Prüfung lohnt
Der Vergleich ist einfach: Prüfkosten je Dokument gegen erwarteten Schaden je Dokument ohne Prüfung. Die Zahlen unten sind Annahmen zur Veranschaulichung, keine Messwerte. Setzen Sie Ihre eigenen ein.
- Prüfen kostet 45 Sekunden bei 40 EUR Stundensatz: 0,0125 h × 40 EUR = 0,50 EUR je Dokument.
- Fall A, Rechnungen mit Zahlung: Ein unentdeckter Fehler kostet 30 EUR (Rückfrage, Korrekturbuchung, im schlechten Fall eine falsche Überweisung). Tritt er bei 5 von 100 Dokumenten auf, ist der erwartete Schaden 0,05 × 30 EUR = 1,50 EUR je Dokument. Das ist mehr als 0,50 EUR: Prüfen lohnt sich.
- Fall B, Ablage von Kassenbons, bei denen ein Fehler 5 EUR kostet und in 2 von 100 Fällen vorkommt: erwarteter Schaden 0,02 × 5 EUR = 0,10 EUR. Das ist weniger als 0,50 EUR: Eine Stichprobe genügt.
Für Zahlungen, Steuer und Verträge prüfen Sie also vollständig oder zumindest jedes Dokument, an dem eine Regel anschlägt. Für Vorgänge mit geringem Schaden reicht die Stichprobe. Die Kostenseite der Prüfung rechnen wir im Artikel Was kostet Dokumentenverarbeitung pro Dokument? mit durch.
Was Studien zeigen
Öffentliche Zahlen zur Zuverlässigkeit sind knapp und selten auf deutsche Belege übertragbar. Zwei Quellen helfen bei der Einordnung.
Eine Studie zu Rechnungen. Berghaus, Berger, Hillebrand, Cvejoski und Sifa haben acht multimodale Sprachmodelle aus drei Familien (GPT-5, Gemini 2.5 und das offene Gemma 3) auf drei öffentlichen Rechnungs-Datensätzen verglichen, im Zero-Shot-Verfahren, also ohne Beispiele im Prompt. Sie verglichen die direkte Analyse des Bildes mit der Umwandlung in Markdown vor der Auswertung. Ergebnis laut Zusammenfassung: Die native Bildverarbeitung schneidet im Allgemeinen besser ab als die strukturierten Ansätze. Es ist ein Preprint vom 29. August 2025 auf arXiv (2509.04469). Die Studie bestätigt den Weg über das Bild. Sie sagt nichts darüber, wie hoch die Fehlerquote in Ihrer Buchhaltung sein wird.
Ein Benchmark eines Anbieters. LlamaIndex, der Anbieter von LlamaExtract, hat am 11. August 2026 den Benchmark ExtractBench veröffentlicht: 370 Dokumente mit 4.869 Seiten aus 67 Dokumenttypen, 14 getestete Systeme. Das eigene Produkt (Stufe "Agentic Plus") kommt darin auf 95,6 % Value-F1 bei 8,1 Cent je Seite und führt die Wertung an. Lesen Sie das mit Vorsicht: Der Anbieter hat den Benchmark selbst aufgesetzt und schneidet darin am besten ab, es besteht ein Interessenkonflikt. Zwei Befunde sind trotzdem für unser Thema wichtig. Bei Dokumenten mit mehr als 50 Seiten fällt laut LlamaIndex der Recall aller kommerziellen Vision-Modelle unter 35 %, bei weiterhin hoher Präzision: Sie lassen also Werte aus, statt falsche zu liefern. Und Belege: Die Vision-Modelle und Coding-Agenten lieferten standardmäßig keine Fundstelle und wurden dafür mit null bewertet. Nachweis am Original ist demnach heute eher die Ausnahme als der Standard.
Ein eigener kleiner Test
Wir haben selbst gemessen, mit deutlicher Einschränkung: Es ist ein interner Test auf fünf Beispieldokumenten, kein Benchmark und keine Zusage einer Genauigkeit von Plurali. Die Dokumente waren Beispiele (Rechnung, Vertrag, Kassenbon, Lieferschein, Kontoauszug) mit zusammen 190 Feldern. Wir haben die Seiten als Bild übergeben und mehrere Modelle mit je zwei Läufen verglichen.
Auffällig war nicht die Zahl, sondern die Verteilung. Die falsch gelesenen Felder waren bei allen Modellen weitgehend dieselben: der Vertragspartner, die Kündigungsfrist, die Filiale und einzelne Positionen auf dem Kassenbon. Ein anderes Modell änderte daran wenig. Unsere Vermutung, nicht bewiesen: Die Ursache liegt eher in den Feldern und Dokumenten als im Modell. Beim Vertrag ist unklar, wer "der Vertragspartner" aus Sicht des Lesers ist. Eine Kündigungsfrist steht mal in Tagen, mal in Monaten und mal in einem Verweis auf einen anderen Paragrafen. Auf Kassenbons sind Positionen abgekürzt und eng gesetzt.
Zwei Schlüsse für die Praxis. Erstens: Formulieren Sie mehrdeutige Felder präziser, das bringt oft mehr als ein anderes Modell. Zweitens: Auch bei einer hohen Trefferquote bleiben auf einem Stapel Dokumente einzelne falsche Felder. Für Anwendungen mit Zahlungen führt das zur Prüfung, die oben beschrieben ist. Wir stützen uns auf fünf Dokumente. Ihre Dokumente können ganz anders ausfallen.
Was heißt das für Ihren Ablauf
- Definieren Sie Felder eindeutig, optionale Felder als nullbar, mit einer Beschreibung, wann
nullgilt. - Verlangen Sie für die wichtigen Felder eine Fundstelle (Seite, Ausschnitt) und prüfen Sie den Ausschnitt maschinell.
- Rechnen Sie nach: Summen, Steuersätze, Datumsreihenfolge, IBAN.
- Schicken Sie Dokumente mit fehlgeschlagener Prüfung an einen Menschen, den Rest mit einer Stichprobe.
- Messen Sie mit einer eigenen Stichprobe: 50 Ihrer Dokumente von Hand prüfen und Fehler nach Feld zählen. Das sagt mehr als jede Herstellerzahl.
Wie sich die Verarbeitung und Aufbewahrung rechtlich einordnen lässt, behandelt der Artikel KI-Dokumentenverarbeitung in Deutschland: DSGVO, GoBD und Aufbewahrung. Der Überblick über den ganzen Ablauf steht im Leitfaden zur intelligenten Dokumentenverarbeitung. Speziell für Rechnungen gibt es den Artikel zum automatischen Auslesen von Rechnungen.
Quellen
Abgerufen am 29. September 2026.
- Berghaus, Berger, Hillebrand, Cvejoski, Sifa: Multi-Modal Vision vs. Text-Based Parsing: Benchmarking LLM Strategies for Invoice Processing, arXiv:2509.04469, eingereicht am 29. August 2025 (Preprint): arxiv.org/abs/2509.04469
- LlamaIndex: Introducing ExtractBench, 11. August 2026 (Benchmark eines Anbieters, Interessenkonflikt): llamaindex.ai/blog/introducing-extractbench
- Interner Test auf fünf Beispieldokumenten (29. September 2026): kein Benchmark, nicht veröffentlicht.
Weiter im Journal
- Felder definieren: Wie Sie aus einem Dokument genau die Daten bekommen
- Was kostet Dokumentenverarbeitung pro Dokument?
Rechnung im Playground ausprobieren: Laden Sie eine Rechnung hoch, verlangen Sie neben dem Betrag eine Fundstelle und prüfen Sie das Ergebnis mit den Regeln aus diesem Artikel.